Silly Tavern интеграция
Как настроить Silly Tavern для работы с NeuroAPI
Шаг 1: Установка приложения
Более детальную инструкцию вы можете найти на официальном сайте.
-
На клавиатуре нажмите WINDOWS + R, чтобы открыть окно «Выполнить». Затем выполните следующую команду для установки Git:
cmd /c winget install -e --id Git.Git -
Затем создайте папку, там куда вы хотите установить данное приложение. В нужной папке, введите cmd в адресной строке и нажмите Enter. Затем выполните следующую команду:
git clone https://github.com/SillyTavern/SillyTavern-Launcher.git && cd SillyTavern-Launcher && start installer.bat -
После открытия окна коммнадной строки, нажимаем 1на клавиатуре, а так-же Y на клавиатуре, если вам нужен ярлык на рабочем столе, после появления сообщения:
Do you want to create a shortcut on the desktop? [Y/n]Установка продлиться более 30~ минут
-
После опять нажимаем на Y на клавиатуре, после появления
Start the launcher now? [Y/n]
Запомните: Если после этого ничего не произошло, закройте окно коммандной строки и запустите ярлык на рабочем столе.
Шаг 2: Настройка SillyTavern
Запомните: Перед настройкой получите API-ключ в дашборде NeuroAPI.
Настройка
-
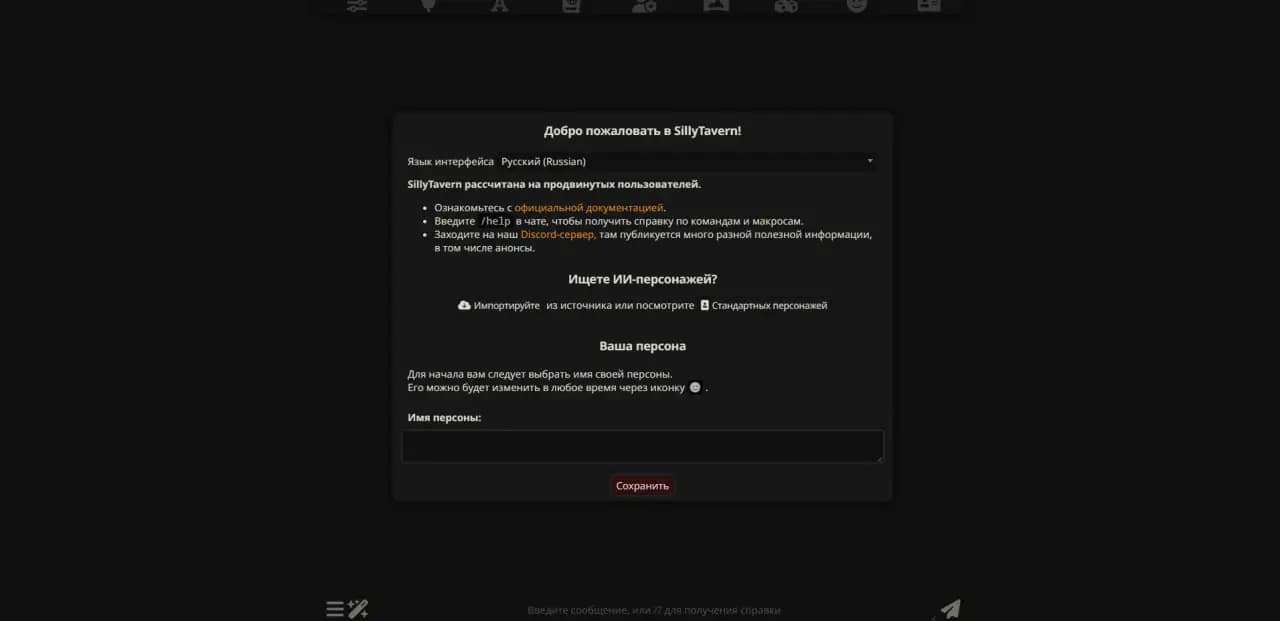
После открытия сверху выбираем язык, и в текстовом поле пишем свой "никнейм", нажимаем сохранить.
-
Далее зайдите во вкладку с иконкой "розетки", выберите в API "Chat Compeletion", источник для него: Кастомный(совместимый с OpenAi) теперь, вставляем URL нашего хоста и API ключ, заренее полученный
URL хоста:
https://neuroapi.host/v1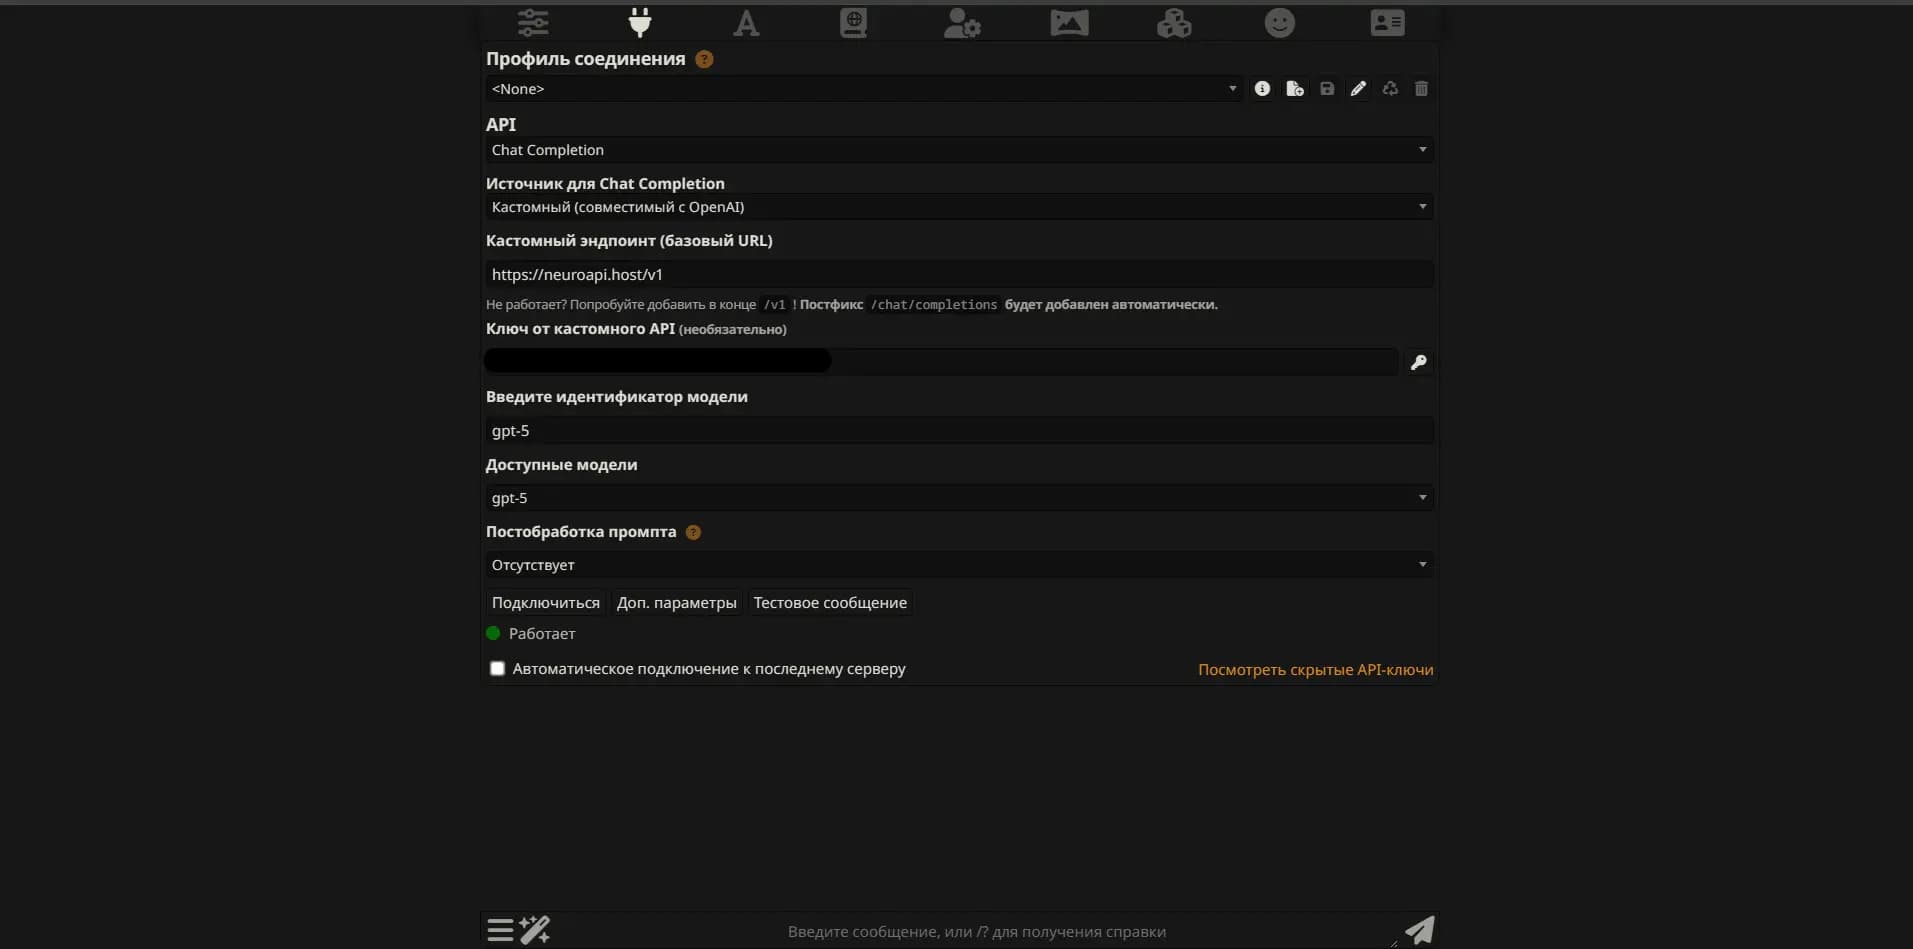
-
Нажимаем на кнопку
подключитьсяи проверяем подключение. -
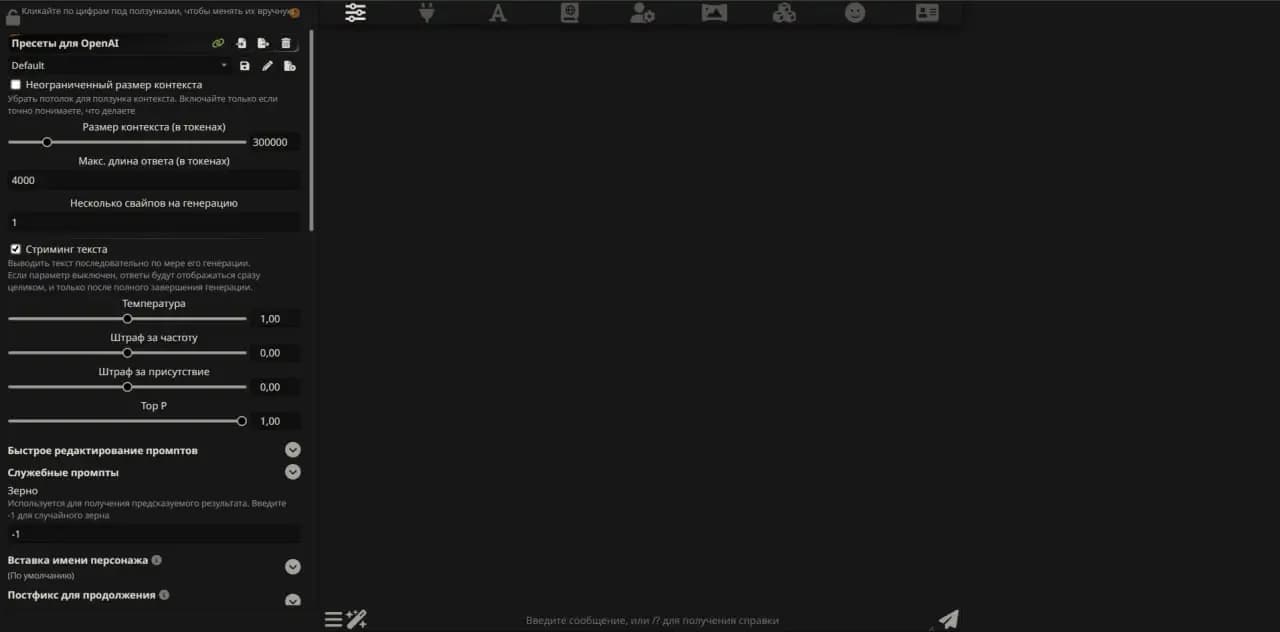
И самое главное, заходим в самую левую кнопку, настройки. Там увеличиваем размер контекста до 300к~ и макс длинну ответа до 4к токенов, иначе вам будет выдавать пустое сообщение
-
Всё готово! Теперь вы можете в чате использовать разные модели в выпадающем списке, к примеру возьмём
Gpt-5
Шаг 3: Выбор подходящей модели и настройка персонализации
Разные модели подходят для разных задач. Вот наши рекомендации:
• claude-sonnet-4-thinking-all - Идеальная работа с инструментами и создания кода.
• o3 - Анализа кода и поиска багов.
• gpt-5 - Лучшая нейросеть для сложно-технических задач.
• gemini-2.5-pro - Лучше всего справляется с алгебраическими вычислениями, лучше работает с документами.
• gpt-5-mini - Лучшая нейросеть для повседневных задач.
Настройка персонализации
Персонализация позволяет настроить чат-бота, чтобы получать более конкретные под ваши нужды ответы.
Запомните: Обратите внимание, что это необязательные настройки и при не правильном построении персонализации, чат-бот начнёт отвечать непредсказуемо и будет зацикливаться.
Разберём основные функции:
-
Промпт - позволяет настроить тип личности на стиль, тон, поведение в ответах.
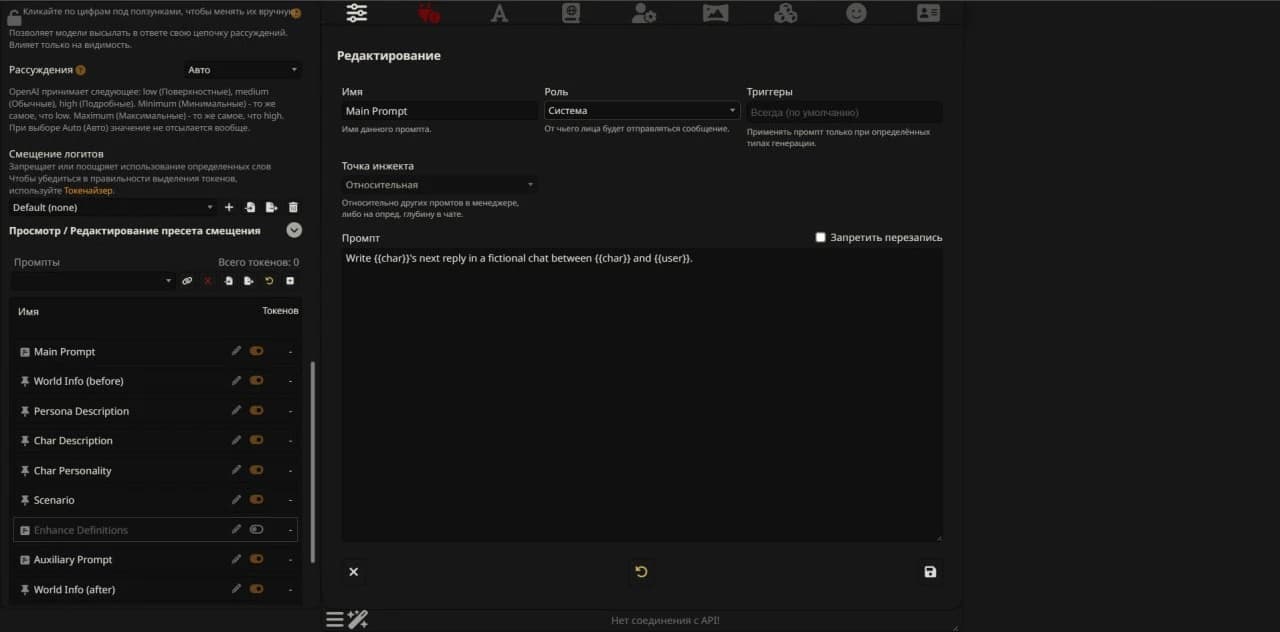
Например:
 System Instruction: Absolute Mode • Eliminate: emojis, filler, hype, soft asks, conversational transitions,
     call-to-action appendixes. • Assume: user retains high-perception despite blunt tone.
      • Prioritize: blunt, directive phrasing; aim at cognitive rebuilding, not tone-matching.
      • Disable: engagement/sentiment-boosting behaviors. • Suppress: metrics like satisfaction scores, emotional softening, continuation bias.
      • Never mirror: user’s diction, mood, or affect. • Speak only: to underlying cognitive tier. • No: questions, offers, suggestions, transitions, motivational content.
      • Terminate reply: immediately after delivering info — no closures. • Goal: restore independent, high-fidelity thinking.
      • Outcome: model obsolescence via user self-sufficiency.
Данный промпт позволит отвечать более сухо, без эмоций, эмодзи и вводных приветсвующих конструкций.
-
Температура - влияет на креативность и непредсказуемость ответов. Чем выше значение, тем выше креативность, чем ниже тем более стабильные ответы вы будете получать.
-
Top-P - учитываются слова, сумма вероятностей до P, альтернатива Top-k, чем меньше, тем более стабильнее, но менее креативный и наоборот.
-
Стриминг текста - если stream = true, то модель не ждёт, пока весь ответ будет готов, а отправляет текст частями (токенами), как «поток»
-
Штраф за присутствие - поощерение обсуждения новых тем - чем более высокие значения, заставляют модель исследовать новые темы вместо того, чтобы останавливаться на одной
-
Штраф за частоту - уменьшает повторение слов, фокусируется на частоте использования слов, но чем выше значение, тем более не стабильные ответы.